쉬운 설명
스스로 일을 척척 처리하는 AI 에이전트는 생각보다 긴 글을 쓸 일이 많지 않아요. 그보다는 "지금 상황에서 어떤 버튼을 누를까?", "여러 선택지 중 뭐가 정답일까?"처럼 재빠르게 결정해야 하는 순간을 훨씬 더 자주 마주하죠. CLM(대조 언어 모델, Contrastive LM)은 바로 이런 '빠른 선택'을 똑소리 나게 잘하도록 만든 모델이에요. 문장을 길게 새로 짓는 대신, '현재 상황'과 '내가 할 수 있는 행동들'을 각각 점수로 바꿔서 둘이 얼마나 잘 맞는지 견줘본 뒤 가장 알맞은 답을 골라냅니다. 사람이 곰곰이 고민해서 글을 쓰기보다, 객관식 문제를 보자마자 감으로 척 찍어내는 모습과 비슷하다고 보시면 돼요.
요약
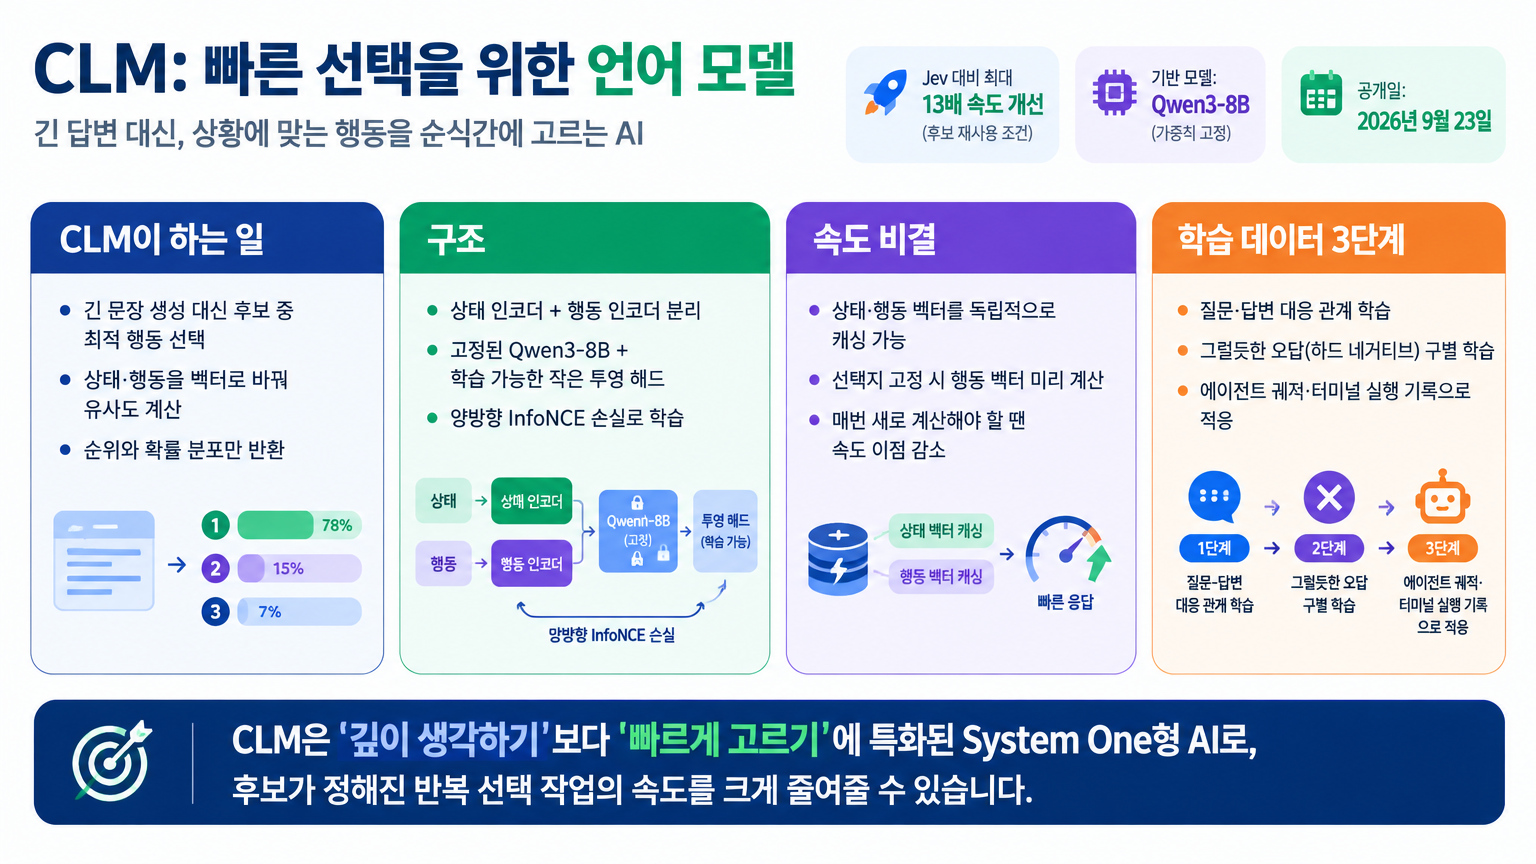
2026년 9월 23일, 연구팀이 'CLM-v0.1-8B'라는 새 모델을 선보였습니다. 기존 Qwen3-8B 언어 모델을 뼈대로 삼고, 그 위에 상태(현재 상황)와 행동(선택지)을 벡터로 바꿔주는 작은 층만 얹어서 학습시킨 구조인데요. 상태와 행동을 하나의 벡터 공간에 올린 뒤, 코사인 유사도(두 벡터의 방향이 얼마나 닮았는지 보는 척도)로 점수를 매겨 가장 어울리는 선택지를 고릅니다. 자유롭게 글을 써 내려가는 보통의 언어 모델과 달리, 정해진 보기 중에서 순위와 확률만 매긴다는 점이 핵심이에요.
이 모델의 가장 큰 무기는 바로 압도적인 속도입니다. 상태와 행동을 따로따로 벡터로 변환할 수 있다 보니, 게임처럼 선택지가 고정된 환경이라면 행동 벡터는 미리 계산해 두고 상황이 바뀔 때마다 상태 벡터만 새로 구하면 되거든요. 실제로 약 1,000개의 보기를 비교하는 실험에서 기존 비교 모델(Jev)보다 약 13배나 빠른 속도를 보여주었습니다. 다만 이는 선택지 데이터를 미리 계산해 재사용할 수 있을 때의 결과예요. 매번 모든 내용을 처음부터 계산해야 하는 환경이라면 이만큼의 속도 차이는 나지 않는다고 연구팀도 솔직히 밝혔습니다. 한편 학습 데이터는 '질문-답변'에서 출발해 '그럴듯한 오답 가려내기', '실제 에이전트의 행동 데이터' 순으로 차근차근 설계했는데요. 덕분에 모델이 원래 갖고 있던 기본 언어 능력을 잃지 않으면서도 에이전트 작업에 알맞게 다듬어질 수 있었습니다.
활용 포인트
AI 에이전트나 서비스를 개발하는 분들이라면 도구 호출(function calling)이나 다음 동작 결정처럼 '보기 중에서 하나를 재빨리 골라야 하는' 단계에 이 CLM 방식을 검증기(validator)나 순위 결정 모델로 써먹기 좋습니다. 예컨대 코딩 에이전트가 코드 수정안 후보를 여럿 뽑았을 때, 덩치 큰 언어 모델에게 매번 "어느 게 제일 좋아?"라고 물어볼 필요가 없어요. 상태-행동 벡터의 유사도를 따져 빠르게 1차로 걸러낸 뒤, 최종 후보만 큰 모델에게 넘겨주면 비용과 시간을 아낄 수 있죠. 게임 AI나 챗봇 추천처럼 보기 목록이 반복되는 서비스라면, 행동 벡터를 미리 저장(캐싱)해 두고 상태만 새로 계산해 응답 시간을 획기적으로 줄여볼 수도 있습니다.
서비스를 기획하거나 AI를 공부하는 분들에게도 좋은 힌트가 됩니다. "모든 문제를 무조건 큰 언어 모델로 풀어야 한다"는 생각에서 벗어나, 직관적이고 빠른 판단이 필요한 영역과 깊은 고민이 필요한 영역을 쪼개어 설계할 수 있으니까요. 원문에서 CLM을 '시스템 1'(빠르고 직관적인 사고)에 빗댄 것처럼, 실제 서비스를 만들 때도 "감으로 빠르게 고를 일"과 "신중하게 생각해야 할 일"을 분리해 서로 다른 모델을 짝지어 주는 하이브리드 구조를 고민해 보시면 좋겠습니다.
주의 사항
그렇다고 CLM이 모든 걸 해결해 주는 마법은 아니에요. 정답이 보기 목록 안에 없으면 아예 새로운 답을 지어내지 못하고, 계산되어 나오는 확률 역시 '절대적인 성공 가능성'이 아니라 주어진 보기 안에서의 '상대적인 점수'일 뿐이라는 점을 염두에 두어야 합니다. 또한 13배 빨라졌다는 수치도 약 1,000개의 선택지를 재사용할 수 있는 특별한 실험 조건에서 나온 것이라, 매번 상태와 보기를 몽땅 새로 계산해야 하는 작업에서는 비슷한 수준의 속도를 기대하기 어려워요. 아울러 공개된 투영 헤드는 Qwen3-8B의 고유한 임베딩 구조에 딱 맞춰 학습된 것이어서, 다른 임베딩 모델에 그대로 가져다 쓰기는 어렵다는 점도 챙겨두셔야 합니다. 마지막으로 이 모델은 2026년 9월 23일에 공개된 v0.1 초기 버전인 만큼, 앞으로 업데이트되면서 구체적인 수치나 세부 구조가 바뀔 수 있습니다.
자체 검증
원문과 꼼꼼히 비교해 본 결과, 본문에 정리한 핵심 내용은 모두 원문과 정확히 맞아떨어집니다. CLM-v0.1-8B가 Qwen3-8B를 고정 인코더로 두고 투영 헤드만 따로 학습시켰다는 점, 양방향 InfoNCE 손실을 썼다는 점, 약 1,000개 후보 비교 실험에서 Jev 대비 13배 속도 개선을 기록했다는 점과 이 수치가 후보 재사용 조건에 한정된다는 사실 모두 원문에 고스란히 담겨 있어요. 학습 데이터를 '질문-답변 → 하드 네거티브 → 에이전트 궤적(기존 데이터 40% + 에이전트 데이터 60% 혼합)'으로 짰다는 내용과, 그에 따른 정확도 변화 수치(69%→68.5% vs 56.2%, 52.1%→69.2% vs 62.4%) 역시 왜곡 없이 그대로 반영했습니다. 다만 원문 끝자락의 계산 예산 고정 시 헤드 크기 실험 내용은 문장이 중간에 잘려 있어 명확한 결론을 알 수 없었기에, 불필요한 혼선을 줄이고자 본문에서는 다루지 않았습니다.
태그
#AI #CLM #대조학습 #에이전트 #언어모델 #Qwen3 #머신러닝