JEV가 난리네요.
https://typesafe.ai/blog/introducing-system-one-models-and-jev
쉬운 설명
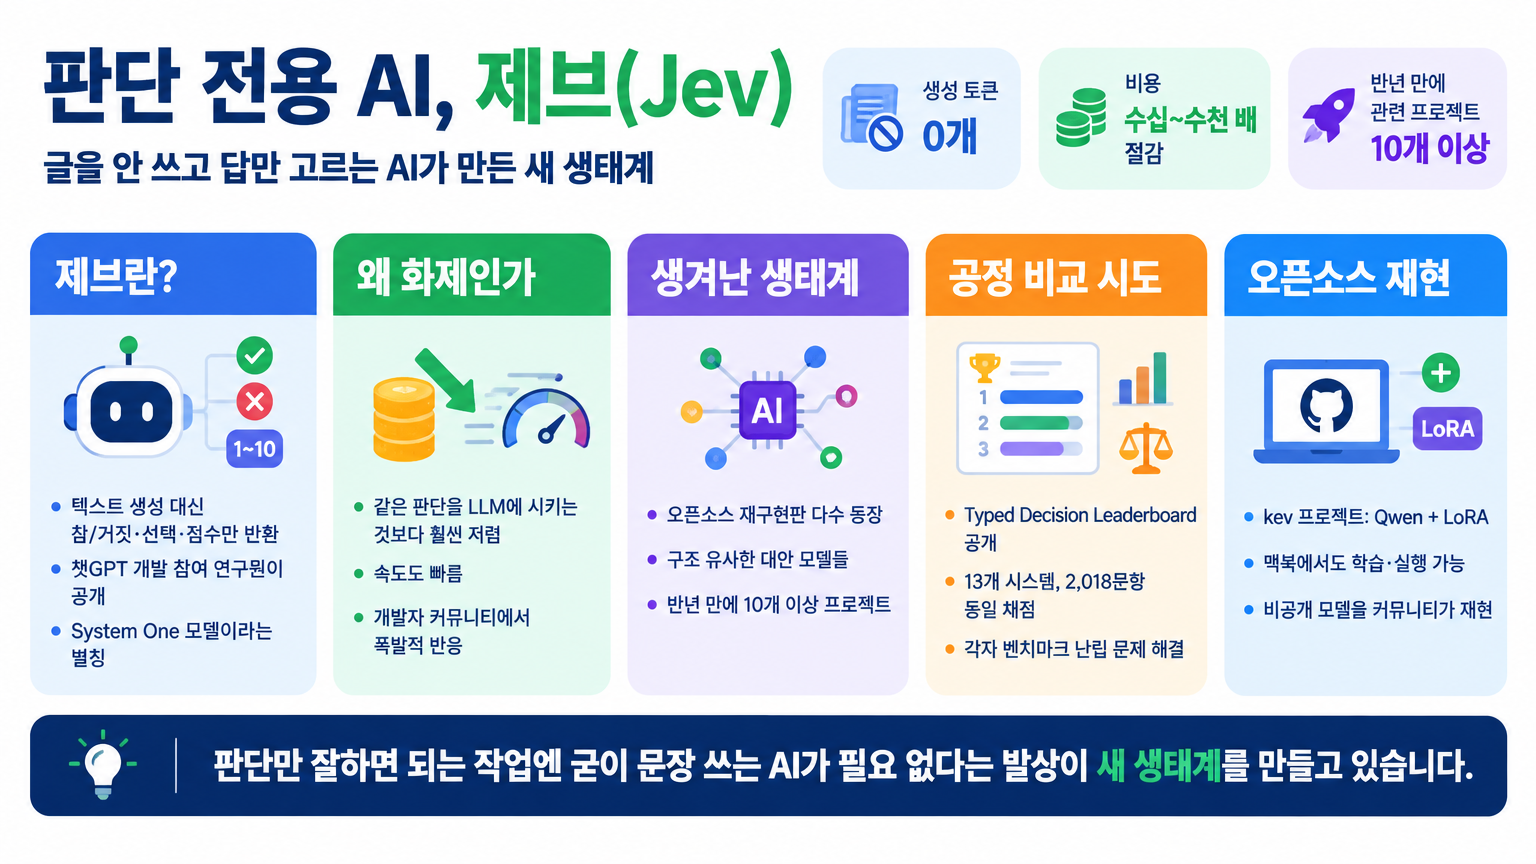
요즘 나오는 AI는 대부분 긴 글을 술술 잘 써내는 걸 장점으로 내세우는데요, '제브(Jev)'라는 모델은 정반대의 길을 걷고 있습니다. 글을 길게 쓰지 않고, 참인지 거짓인지, 몇 점인지, 어떤 선택지가 맞는지처럼 딱 떨어지는 답만 골라주는 AI인 거죠. 예를 들어 "이 고객 문의는 A팀으로 보낼까, B팀으로 보낼까?" 같은 질문을 받으면 구구절절 설명하지 않고 바로 "A팀"이라고만 답해 주는 식입니다. 문장을 한 글자씩 지어내는 과정 자체가 없다 보니 처리 속도도 훨씬 빠르고 비용도 크게 줄어들어, 요즘 개발자들 사이에서 큰 화제가 되고 있답니다.
요약
챗GPT 개발에 참여했던 연구원이 공개한 제브는 '판단 전용 AI'라는 새로운 분야를 열었습니다. 기존의 거대 언어모델(LLM, 방대한 텍스트를 배워 사람처럼 글을 이해하고 만들어내는 AI)은 아무리 간단한 '예/아니오' 질문이라도 글자를 하나하나 생성하는 방식을 거쳐야 해서 시간과 비용이 꽤 들었는데요. 제브는 이런 불필요한 과정을 싹 없애고 참·거짓, 선택, 점수처럼 딱 정해진 답만 바로 건네줍니다. 덕분에 똑같은 판단 작업을 프런티어(최상위급) LLM에 맡길 때보다 비용이 수십 배에서 수천 배까지 저렴하다고 해요.
발표 직후 반응이 무척 뜨거웠던 만큼 관련 생태계도 눈 깜짝할 사이에 커졌습니다. 오픈소스로 다시 구현한 버전부터 구조가 비슷한 대안 모델, 주변 편의 도구까지 합쳐 반년 만에 10개가 넘는 프로젝트가 쏟아져 나왔죠. 그런데 각 모델이 서로 다른 시험지로 자기 성능이 최고라고 자랑하다 보니 객관적인 비교가 어려웠습니다. 그러던 중 한 개발자가 13개 시스템을 모아 2,018개 문항, 동일한 라벨과 채점 코드로 한 번에 비교한 'Typed Decision Leaderboard'를 공개했는데요. 여러 판단 모델을 한자리에 모아 공정하게 줄을 세운 첫 번째 시도로 꼽히며 많은 관심을 받고 있습니다.
활용 포인트
개발자나 실무자라면 '판단만 콕 집어 필요한 작업'에 이 방식을 도입해 볼 만합니다. 예를 들어 고객 문의를 담당 부서로 연결하거나, 리뷰가 긍정인지 부정인지 가려내거나, 게시물이 규정을 어겼는지 검토하는 일처럼 단순 분류 작업을 매번 값비싼 대형 LLM에 맡기고 계셨다면, 이 부분만 판단 전용 모델로 바꿔보는 거죠. 특히 하루에 수천에서 수만 건씩 쏟아지는 대규모 분류·필터링 업무라면, 글자(토큰)를 생성하는 비용 자체가 들지 않아 서버 인프라 비용을 눈에 띄게 아낄 수 있습니다.
기획자나 공부하는 분들이라면 직접 만들어보면서 감을 익히는 것도 좋습니다. 자료3에서 소개된 'kev' 프로젝트는 'Qwen'이라는 오픈소스 언어모델에 'LoRA(적은 데이터로도 모델을 가볍게 미세 조정하는 기술)'를 적용해, 일반 노트북에서도 직접 학습시키고 돌려볼 수 있게 만든 재현 버전인데요. 사내 데이터를 바탕으로 "이 요청을 상담사에게 넘겨야 할까?"를 판단해 주는 자체 모델을 고민하고 있다면, 이런 오픈소스 프로젝트를 참고해 가볍게 첫걸음을 떼어보시는 걸 추천합니다.
주의 사항
제브 자체는 내부가 완전히 공개되지 않은 모델이라, 구체적인 내부 구조나 학습 방법까지 낱낱이 밝혀진 것은 아닙니다. 현재 나와 있는 오픈소스 재구현 프로젝트들이 원본 모델만큼 완벽한 성능을 내는지는 아직 더 지켜보고 검증해야 하는 단계예요. 아울러 공개된 리더보드 역시 특정 커뮤니티 사용자가 개별적으로 측정한 결과물이라, 공인 기관의 정식 인증을 받은 데이터는 아니라는 점도 고려해야 합니다. 테스트에 쓰인 시험 문항이나 채점 기준이 여러분이 맞닥뜨릴 실제 업무 환경과는 조금 다를 수 있다는 점도 꼭 염두에 두세요.
자체 검증
원문 자료들과 비교해 보면 핵심 내용은 모두 잘 부합합니다. 제브가 '문장을 길게 만들지 않고 참·거짓·선택·점수 같은 유형화된 판정 결과만 내놓는다'는 점, 그리고 '생성 토큰이 0개라 프런티어 LLM보다 수십~수천 배 저렴하다'는 설명은 자료2에 뚜렷하게 나와 있습니다. '챗GPT 개발 핵심 역할을 맡았던 연구원이 공개했다'는 사실도 자료1의 제목과 정확히 일치하고요. 다만 자료1은 본문 상세 내용이 생략되어 있어 더 깊은 배경 근거까지는 확인하기 어려웠으며, kev 프로젝트가 실제로 '맥북에서 학습과 실행이 가능하다'는 대목은 자료3의 제목을 그대로 반영한 것으로 구체적인 세부 성능 수치까지는 원문에서 확인되지 않았습니다.
태그
#AI #LLM #판단모델 #오픈소스 #머신러닝 #벤치마크 #LoRA
원문
https://www.aitimes.com/news/articleView.html?idxno=215506
https://typesafe.ai/blog/introducing-system-one-models-and-jev
https://discuss.pytorch.kr/t/jev-13/11968
https://discuss.pytorch.kr/t/kev-jev-qwen-lora/11963
참고자료
LoRA: Low-Rank Adaptation of Large Language Models (arXiv)
https://www.youtube.com/watch?v=lx3YkhzM_04