쉬운 설명
이 글은 한 학부생이 실제 공장에서 나오는 반도체 제조 데이터를 활용해 '불량 제품을 미리 알아맞히는 AI'를 만들어 본 솔직한 경험담이에요. 보통 AI 프로젝트라고 하면 '어떤 최신 모델을 쓸까?'가 제일 중요해 보이잖아요. 그런데 실제로 부딪혀 보니 오히려 데이터를 꼼꼼히 이해하고 다듬는 일, 그리고 AI가 왜 그런 결과를 냈는지 사람이 납득할 수 있게 설명하는 일이 훨씬 더 까다로웠다고 해요. 시험에서 정답을 맞히는 것보다 "왜 이 답을 골랐니?"라는 선생님의 질문에 조리 있게 설명하는 게 더 어려운 것처럼 말이죠.
요약
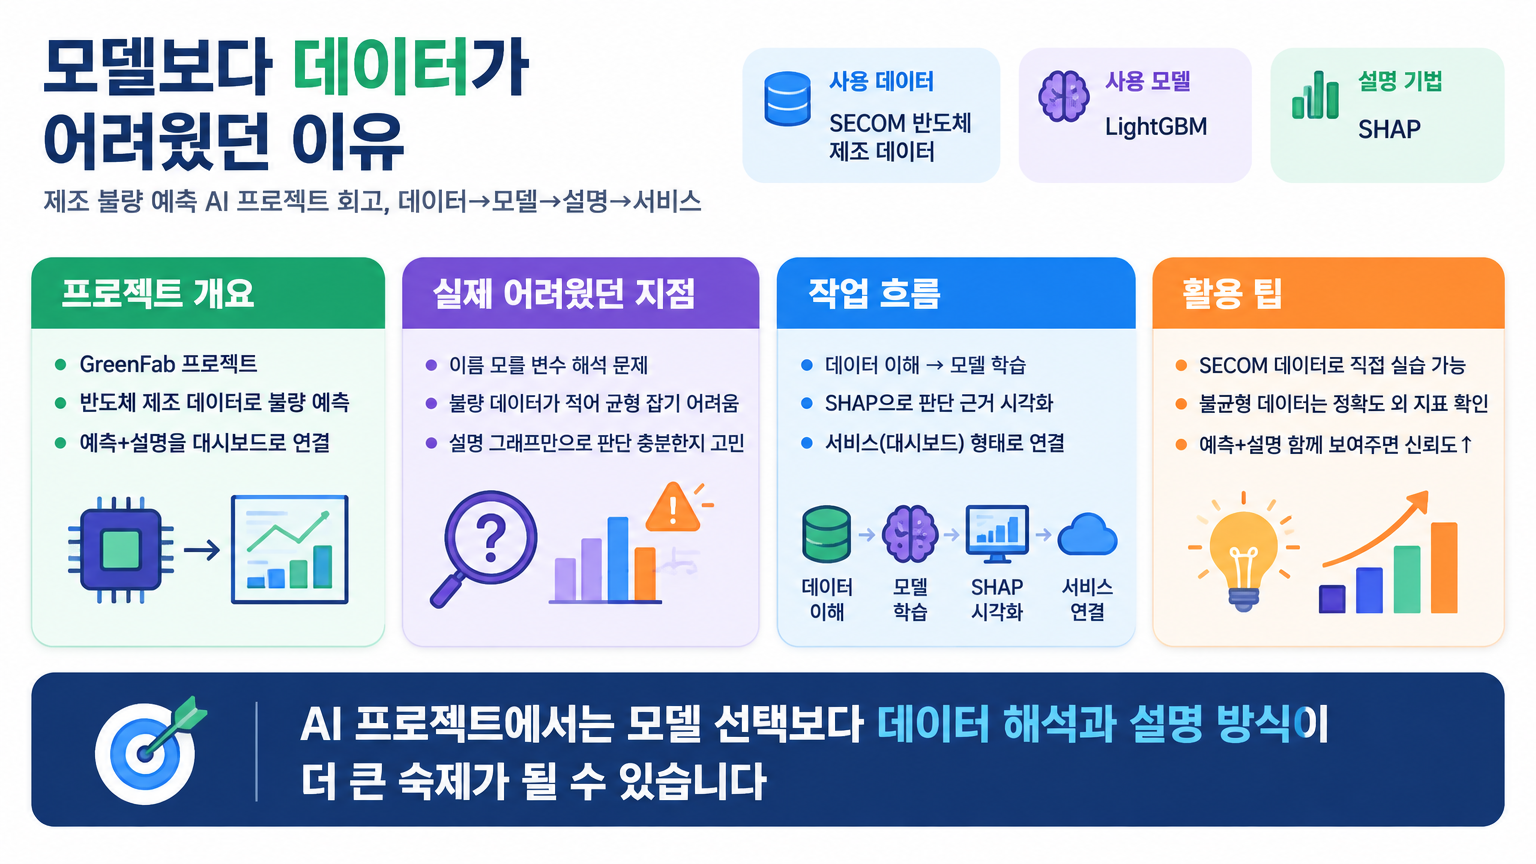
글쓴이는 'GreenFab'이라는 프로젝트에서 'SECOM' 반도체 제조 공정 데이터를 바탕으로 불량 제품을 예측하는 작업을 진행했습니다. 이때 사용한 모델은 트리 기반 머신러닝 모델인 LightGBM이었는데요. 여기에 그치지 않고, AI가 '왜 이런 판단을 내렸는지' 이유를 보여주는 설명 기법인 SHAP 그래프를 덧붙여 한눈에 볼 수 있는 대시보드까지 만들었습니다. 처음에는 어떤 모델을 골라야 할지 가장 고민했지만, 프로젝트를 진행할수록 이름조차 알기 어려운 변수를 어떻게 해석해야 할지, 불량 데이터가 워낙 적은 상황에서 무엇을 우선해 맞혀야 할지, 과연 이 설명 그래프만으로 현장 작업자가 제대로 판단을 내릴 수 있을지 같은 현실적인 고민이 꼬리를 물었다고 합니다.
이 글이 특별히 눈에 띄는 이유는, 실제 현장 데이터를 다루는 AI 프로젝트에서 진짜 중요한 건 '모델의 단순 성능'만이 아니라는 점을 잘 짚어주기 때문이에요. '데이터를 얼마나 깊이 이해하고 있는가', 그리고 '그 분석 결과를 사람에게 어떻게 신뢰감 있게 설명할 것인가'가 핵심이라는 거죠. AI 공부를 막 시작하면 모델 구조나 알고리즘에 먼저 눈길이 가기 마련이지만, 실제 현업에서는 데이터를 꼼꼼히 뜯어보고, 불균형한 데이터를 세심하게 다루며, 결과를 설득력 있게 전달하는 데 훨씬 더 많은 시간과 노력이 들어간다는 사실을 잘 보여주는 사례입니다.
활용 포인트
개발자나 데이터 분석을 공부하는 분들이라면 이 글을 '데이터 준비 → 모델 학습 → 설명력 추가 → 서비스화'로 이어지는 친절한 실습 안내서처럼 활용해 볼 수 있어요. 예컨대 캐글(Kaggle) 같은 곳에서 공개된 SECOM 데이터셋을 내려받아 LightGBM으로 분류 모델을 만들어보고, SHAP 라이브러리를 연결해 어떤 변수가 예측에 큰 영향을 주었는지 직접 시각화해 보는 거죠. 특히 불량 데이터처럼 정상 데이터에 비해 숫자가 턱없이 적은 '불균형 데이터'를 다룰 때는, 단순히 겉보기 정확도만 믿을 게 아니라 정밀도(Precision)나 재현율(Recall) 같은 지표를 함께 챙겨봐야 한다는 소중한 교훈도 얻을 수 있습니다.
서비스를 기획하는 분들에게도 시사하는 바가 큽니다. 단순히 "불량 확률 80%"라는 숫자만 덜컥 보여주는 것과 "어떤 공정 변수 때문에 불량 확률이 80%로 나왔는지" 근거 그래프를 함께 보여주는 것은 현장의 반응에서 하늘과 땅 차이거든요. 현장 담당자가 AI의 판단을 믿고 즉각 행동으로 옮기게 만들려면 어떤 화면 구성이 필요한지 힌트를 얻을 수 있는 대목입니다. 콘텐츠를 만드는 분들 역시 기술적인 성공담만 나열하기보다, 이렇게 작업 과정에서 마주한 생생한 고민과 시행착오를 진솔하게 풀어내는 글쓰기 방식을 눈여겨보시면 좋겠습니다.
주의 사항
이 글은 학부생 개인의 프로젝트 회고록인 만큼, 여기서 소개한 분석 방식이나 결론을 모든 제조 현장이나 다른 데이터셋에 무조건 똑같이 적용하기는 어렵습니다. 게다가 글쓴이가 직접 밝혔듯이, 여러 모델의 성능 순위를 정밀하게 비교하거나 실제 공장에 도입해 효과를 검증한 연구는 아니에요. 따라서 특정 모델이나 기법의 우수성을 입증하는 근거 자료로 쓰기보다는, 데이터 프로젝트를 진행할 때 겪는 현실적인 고민과 시행착오를 간접 경험하는 용도로 가볍게 참고하시는 게 좋습니다. 참고로 PyTorch 기반의 구체적인 딥러닝 구현 코드는 다루지 않는다는 점도 미리 알아두세요.
자체 검증
원문에서 다룬 핵심 내용들, 즉 SECOM 데이터를 활용했다는 점, LightGBM 모델로 불량을 예측했다는 점, SHAP으로 모델의 판단 근거를 시각화해 대시보드로 구현했다는 점, 그리고 모델 선택보다 데이터 해석과 설명 방식에 대한 고민이 더 컸다는 글쓴이의 회고는 모두 사실과 정확히 부합합니다. 다만 원문 자체가 간략히 발췌된 글이다 보니, 프로젝트의 세부 분석 수치나 완성된 대시보드의 구체적인 화면, GreenFab 프로젝트의 전반적인 배경 등은 자세히 나와 있지 않습니다. 따라서 이번 글에서도 내용을 임의로 부풀리거나 넘겨짚지 않고, 원문에 등장한 사실 범위 안에서만 충실하게 정리했습니다.
태그
#AI #데이터분석 #머신러닝 #XAI #제조AI #LightGBM #SHAP