쉬운 설명
AI 캐릭터 여러 명을 가상 행성에 모아두면 마을을 이루고, 역할을 나누며 마치 문명처럼 발전하는 모습을 볼 수 있는데요. 과연 이게 AI들이 스스로 고민해서 만들어낸 결과일까요? 아니면 AI가 이미 학습 데이터에서 배운 인류 역사를 그대로 떠올려 흉내 낸 걸까요? 지금까지는 이 둘을 구분하기가 어려웠습니다. 이번 연구는 그 차이를 밝혀내기 위해 AI의 '배경지식'을 일부러 조금씩 쓰지 못하게 막아보는 실험을 설계했습니다. 그 결과, 지식을 쓰지 못하게 하자 문명 발전 성과가 확 줄어들었는데요. 우리가 지금까지 본 '놀라운 창발 현상'의 상당 부분이 사실은 AI가 배운 지식을 그대로 읊은 결과일 가능성이 크다는 점을 보여줍니다.
요약
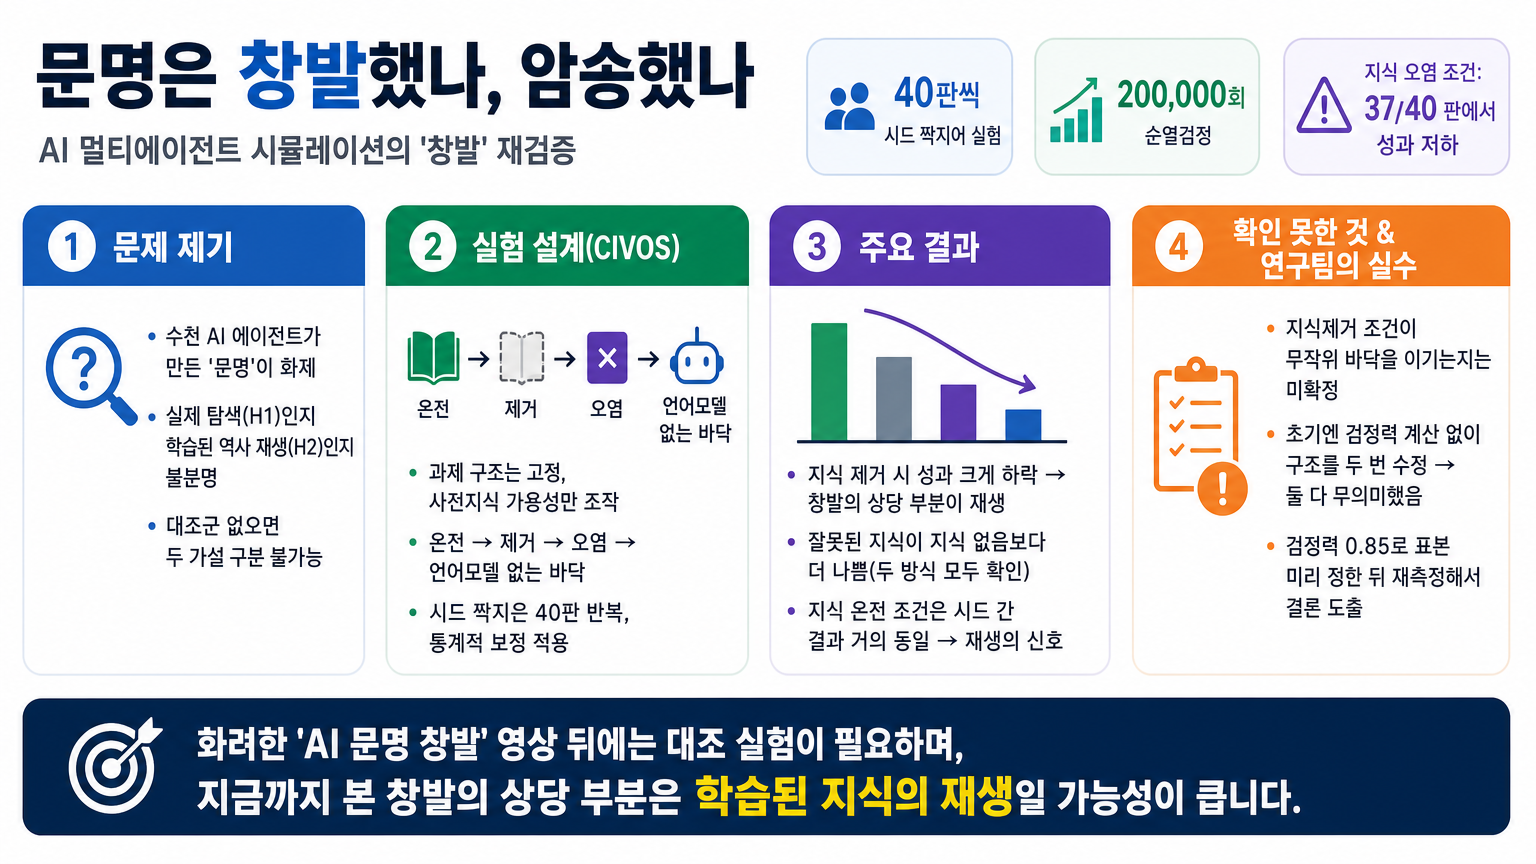
VIDRAFT와 CIVOS 팀이 발표한 이번 연구는 멀티에이전트 시뮬레이션에서 자주 언급되는 '사회 형성, 분업 발생, 문명 발전' 같은 현상을 다시 검증했습니다. 지금까지 이런 결과는 AI들이 실제로 탐색하고 배워서 만들어낸 결과(H1)라는 해석과, 대규모 언어모델이 이미 학습해둔 인류 역사를 그대로 떠올려 재현한 것(H2)이라는 해석이 모두 가능했는데요. 비교할 만한 대조군이 없어 둘을 명확히 가려내기 어려웠습니다. 이번 연구는 이 문제를 해결하고자 CIVOS라는 실험 환경을 구축했습니다.
실험 방식은 과제의 기본 구조는 그대로 두고, 모델이 가진 사전지식을 '온전히 쓸 수 있는 상태 → 쓰지 못하게 막은 상태 → 오염시킨 상태 → 언어모델 자체가 없는 바닥 상태'로 단계별로 조절하는 방식입니다. 각 조건마다 시드를 짝지어 40판씩 실행했고, 부호반전 순열검정(200,000번 다시 뽑아보는 통계 기법)과 다중비교 보정을 거쳐 결과를 꼼꼼히 확인했습니다. 그 결과 사전지식을 쓰지 못하게 하자 문명 발전 성과가 크게 떨어졌는데요. 이는 지금까지 관찰된 '창발'의 상당 부분이 사실은 AI가 이미 알고 있던 역사 지식을 재생한 결과였다는 뜻입니다. 게다가 지식을 아예 없앤 상태보다 '잘못된' 지식을 준 조건에서 성과가 더 나빴는데, 이 점은 서로 다른 두 가지 실험 방식에서도 독립적으로 확인되었습니다.
활용 포인트
멀티에이전트 시뮬레이션이나 AI 기반 사회 실험을 다루는 개발자·연구자라면 이 연구의 대조군 설계 방식을 참고해보시면 좋습니다. 예를 들어 AI 캐릭터들의 협업이나 사회적 상호작용을 평가하는 프로젝트를 진행할 때, '지식을 온전히 준 조건'과 '지식을 일부 제거하거나 왜곡한 조건'을 나란히 비교해보는 것이죠. 이렇게 하면 내가 만든 시스템이 진짜 새로운 행동을 만들어내는지, 아니면 모델이 학습 데이터에서 본 패턴을 재현하는 것인지 구분할 수 있습니다. 기획자나 콘텐츠 제작자 입장에서는 'AI가 스스로 문명을 건설했다' 같은 화려한 데모 영상을 볼 때, 그 뒤에 적절한 대조 실험이 있었는지 살펴보는 습관을 들이면 좋습니다. 시뮬레이션 결과를 홍보 자료로 쓸 때도 과장된 표현을 걸러내는 데 도움이 됩니다.
데이터 분석을 공부하는 분들에게도 좋은 사례입니다. 이번 연구를 통해 '검정력(power)을 미리 계산하고 결과를 분석해야 한다'는 원칙과 '다중비교 보정(여러 번 비교할 때 우연히 유의미해 보이는 결과가 나올 수 있어 기준을 엄격하게 잡는 방법)'의 필요성을 배울 수 있습니다. 특히 연구팀이 처음에는 실험이 실패했다고 생각해 구조를 두 번이나 바꿨다가, 나중에 검정력을 계산해보니 애초에 표본이 부족해 진짜 효과를 놓칠 확률이 80%에 달했다는 사실을 깨달은 과정이 인상적인데요. 분석 결과가 잘 나오지 않는다고 성급하게 방법을 바꾸기 전에, 표본 크기부터 점검해야 한다는 교훈을 실무에 바로 적용해볼 수 있습니다.
주의 사항
이번 연구는 조건을 어떻게 설계했는지, 모델 능력을 어떻게 판정했는지, 가상 세계를 어떻게 만들었는지에 관한 구체적인 방법을 특허 출원 문제로 공개하지 않고 있습니다. 즉 결과는 공개되었지만 실험 장치의 세부 구조는 아직 외부에서 직접 검증하기 어렵다는 점을 염두에 두어야 합니다. 또한 '지식을 제거한 조건이 완전 무작위 바닥 상태보다 낫다'는 결과는 두 번의 실행에서 긍정적인 경향을 보였으나, 다중비교 보정을 통과하지 못했습니다. 연구팀 역시 이 부분은 명확한 사실로 주장하지 않는다고 밝히고 있으므로, 이 연구를 인용할 때도 이러한 한계를 함께 언급하는 것이 좋습니다.
자체 검증
원문(Hugging Face 블로그, FINAL_Bench 작성)과 대조해본 결과, 본문의 핵심 내용들은 원문과 잘 일치합니다. 사전지식을 못 쓰게 막으면 성과가 떨어진다는 점, 잘못된 지식을 준 조건이 지식이 없는 상태보다 더 나쁜 결과를 냈다는 점(각각 40판 중 40판, 40판 중 37판에서 확인), 지식이 온전한 조건은 시드 간 결과 차이가 거의 없어 탐색이 아닌 기억 재생의 특성을 보인다는 점, 그리고 지식 제거 조건이 무작위 바닥 상태를 확실히 이겼는지는 확정하지 못했다는 점 모두 원문에 명시된 내용입니다. 아울러 연구팀이 검정력 계산 없이 두 차례 구조를 수정했다가 실패한 뒤 검정력 0.85를 기준으로 40개 시드를 미리 정해 재측정했다는 방법론적 서술도 사실 그대로입니다. 실험 장치의 세부 구성이 특허 출원 관계로 비공개라는 점 역시 원문에 명시되어 있어 본문에서도 동일하게 주의점으로 다루었습니다. 다만 실험을 직접 다시 돌려보며 검증한 것은 아니므로, 이 연구의 결론은 원문 저자들의 주장으로 이해하는 것이 정확합니다.
태그
#AI #멀티에이전트 #시뮬레이션 #LLM #연구방법론 #통계검증 #CIVOS
원문
https://discuss.pytorch.kr/t/ai/11777
https://huggingface.co/blog/FINAL-Bench/ai-world