LLM작업을 하다보면, 검수를 했는데도, 다시 검수를 하면 새로운 문제가 있다고 합니다. 이 실험에 의하면 30%정도만 보고 의견을 내기 때문이라는데요. 주의깊게 보고, 적용할 부분을 찾아봐야겠습니다.
쉬운 설명
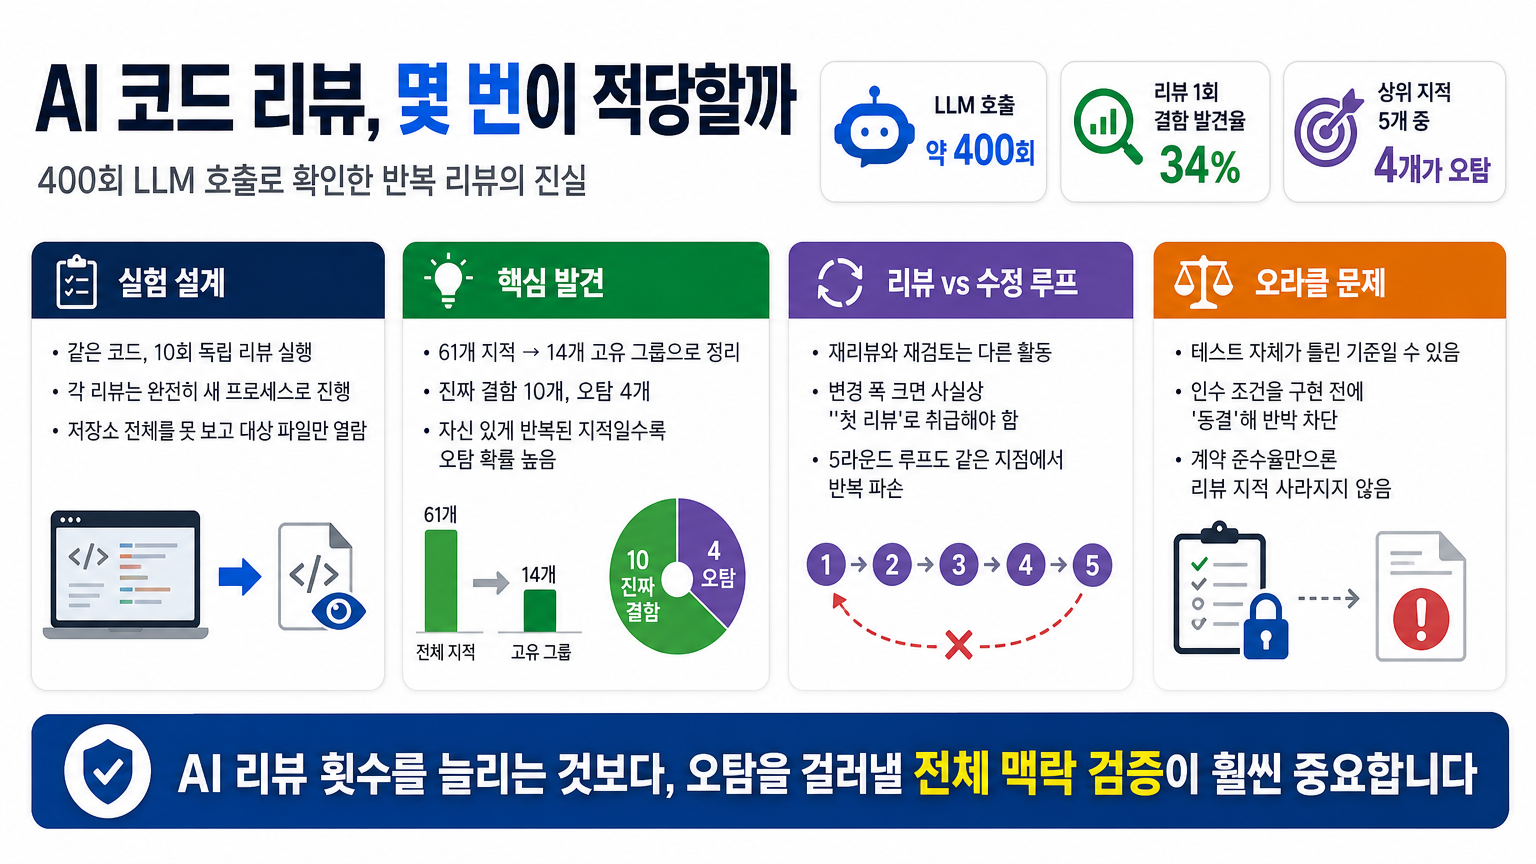
AI에게 코드 검사를 맡기면 한 번에 문제를 싹 찾아줄 것 같지만, 사실은 그렇지 않습니다. 똑같은 코드를 수정하지 않고 서로 다른 AI 리뷰어에게 열 번 보여줬더니 매번 다른 문제를 지적했는데요. 심지어 "이건 확실한 버그입니다!"라며 가장 자신 있게 여러 번 짚어낸 항목들이 알고 보니 전부 엉뚱한 지적이었습니다. 마치 여러 사람에게 틀린 그림 찾기를 시켰더니, 다들 똑같이 엉뚱한 곳을 정답이라고 우기는 상황과 비슷한 셈이죠. 이 연구는 "과연 AI 리뷰를 몇 번이나 돌려야 안심할 수 있을까?"라는 질문에 답하기 위해, AI를 실제로 400번 가까이 호출하며 꼼꼼히 파헤쳐 본 실험 기록입니다.
요약
이 글은 AI에게 코드 리뷰를 반복해서 시키면 버그를 점점 더 많이 찾아낼 것이라는 기대가 과연 사실인지 검증한 결과를 다룹니다. 코드를 전혀 바꾸지 않은 상태에서 독립적으로 열 번 리뷰를 진행해 봤는데요. 총 61건의 지적이 나왔지만, 중복을 빼고 고유한 문제 유형으로 묶어보니 실제로는 14개뿐이었습니다. 그중 진짜 결함은 10개였고, 나머지 4개는 잘못 짚은 '가짜 경고(오탐)'였죠. 더 놀라운 사실은, AI가 가장 자주 그리고 가장 확신을 갖고 지적한 상위 5개 항목 중 무려 4개가 이런 가짜 경고였다는 점입니다. 코드 파일 딱 하나만 보면 그럴듯한 지적 같지만, 프로젝트 전체를 넓게 살펴보면 완전히 틀린 지적이라는 게 드러나는 문제들이었거든요.
결과적으로 가짜 경고를 걸러내지 못하면, 한 번의 리뷰로 실제 결함을 찾아내는 비율은 약 34%(대략 3분의 1 수준)에 그친다는 게 핵심 결론입니다. 또한 이번 연구에서 아주 중요한 통찰 하나를 더 얻을 수 있었는데요. '같은 코드를 단순히 반복해서 검토하는 것'과 '코드를 고친 뒤 다시 검토하는 것'은 완전히 다른 차원의 작업이라는 점입니다. AI가 코드를 한 번 수정한 다음 다시 리뷰를 받는 것은, 사실상 완전히 새로운 코드에 대해 첫 번째 리뷰를 진행하는 것과 같기 때문이죠. 이 둘을 명확히 구분해야 하며, 단순히 "몇 번 돌리면 충분한가요?"라는 질문 자체가 상황에 맞지 않는 잘못된 접근일 수 있음을 보여줍니다.
활용 포인트
실무에서 PR 자동 리뷰 봇 같은 AI 코드 리뷰 도구를 쓰고 계신다면, AI가 파일 하나만 보고 내놓은 결과를 그대로 믿지 말고 전체 저장소 맥락에서 꼭 한 번 더 교차 검증하는 과정을 거치는 것이 좋습니다. 예를 들어 CI 파이프라인에서 'AI 리뷰 3회 자동 반복'을 실행하도록 설정했더라도, 차수가 늘어난다고 해서 품질이 저절로 좋아질 거라 기대하기는 어렵습니다. 그보다는 각 회차에서 나온 지적들을 모아 자주 겹치는 항목과 오탐 가능성이 높은 항목(단일 파일만 보고 유독 확신에 차서 지적한 내용)을 따로 구분해 표시해 주는 방식이 훨씬 효과적입니다. 또한 테스트 코드를 손볼 때는 "이 테스트가 실제 서비스 환경에서 일어날 수 있는 상황을 검사하는가?"를 먼저 따져보는 습관이 필요한데요. 그래야 AI가 덧붙인 방어 코드 때문에 테스트가 깨졌을 때, 무작정 코드 탓부터 하는 실수를 줄일 수 있습니다.
기획자나 팀 리더 입장에서는 'AI 리뷰 통과율'이나 '지적 건수' 같은 단순 수치를 프로젝트 품질 지표로 삼는 것은 위험할 수 있습니다. 그 대신 요구사항을 검증 가능한 문장으로 미리 확정해 두는 '인수 조건'을 개발 전에 단단히 고정해 두고, 이를 바탕으로 성공과 실패를 판정하는 방식을 권장합니다. 그러면 나중에 "테스트 조건이 너무 과했다"며 서로 책임을 떠넘기는 상황을 막을 수 있거든요. 개발을 공부하는 학생이나 입문자라면 이번 실험 과정을 좋은 본보기로 삼아, AI의 답변을 무조건 맹신하기보다 "왜 이런 결과가 나왔을까?"를 비판적으로 되짚어보는 태도를 기르는 데 참고해 보세요.
주의 사항
이번 실험은 특정한 코드베이스와 LLM 호출 환경(약 400회 호출)에서 진행된 결과이며, 저자가 분명히 밝혔듯 특정 AI 모델의 순위를 매기기 위한 벤치마크가 아닙니다. 리뷰가 돌아가는 방식(루프), 프롬프트 작성법, 도구 사용 권한, 검토를 멈추는 조건 등 시스템 전반을 측정한 것이지 모델 자체의 성능 우열을 가린 것이 아니기 때문입니다. 따라서 이 결과를 다른 언어나 다른 모델, 다른 프로젝트에 무작정 적용해 "리뷰는 딱 몇 번만 돌리면 된다"고 일반화해서는 안 됩니다. 실제로 저자 역시 다른 조건에서 일관되게 재확인된 결론은 여섯 개 중 세 개뿐이라고 짚고 있으니, 이 글의 수치는 현실적인 참고 사례 정도로 받아들이는 것이 안전합니다.
자체 검증
원문과 꼼꼼히 대조해 본 결과, '1회 리뷰 시 실제 결함 발견율은 34% 수준'이라는 점, '가장 자주 지적된 상위 5개 항목 중 4개가 오탐이었다'는 내용, 그리고 '전체 실험에서 약 400회의 LLM 호출이 이뤄졌다'는 사실은 모두 원문과 정확히 일치합니다. 아울러 '단순 리뷰 반복과 수정 후 재검토는 서로 다른 활동으로 봐야 한다'는 핵심 주장이나, '인수 조건을 모두 통과(19/19)했더라도 리뷰 지적이 저절로 사라지지 않았다'는 흐름 역시 원문의 맥락을 충실히 담고 있습니다. 다만 원문에서 각 실험에 쓰인 세부 코드(예: ring_push, 재시도 정책 모듈)나 통계 지표(ARI)의 구체적인 수식까지 전부 공개하지는 않았고, 이 글에서는 쉬운 이해를 돕기 위해 일부 설명을 풀어 썼으므로, 더 상세한 수치나 방법론이 궁금하신 분은 원문의 FINDINGS, PRESCRIPTION, README 문서를 직접 살펴보시길 권해드립니다.
태그
#AI코드리뷰 #LLM #소프트웨어테스트 #개발생산성 #벤치마크 #자동화 #품질검증
원문
https://edgelog.dev/ko/blog/how-many-ai-code-reviews