AI와 어떻게 일할 것인지에 대한 방법론이 생산성에 매우 높은 영향을 미치는 시대가 되었습니다. 다양한 방법론을 통해 높은 부가가치를 만들어 보시기 바랍니다. 이 내용은 약간 하네스 엔지니이어링 성격도 갖고 있는 것 같습니다. 제 프로젝트에도 도입을 검토해봐야겠습니다.
쉬운 설명
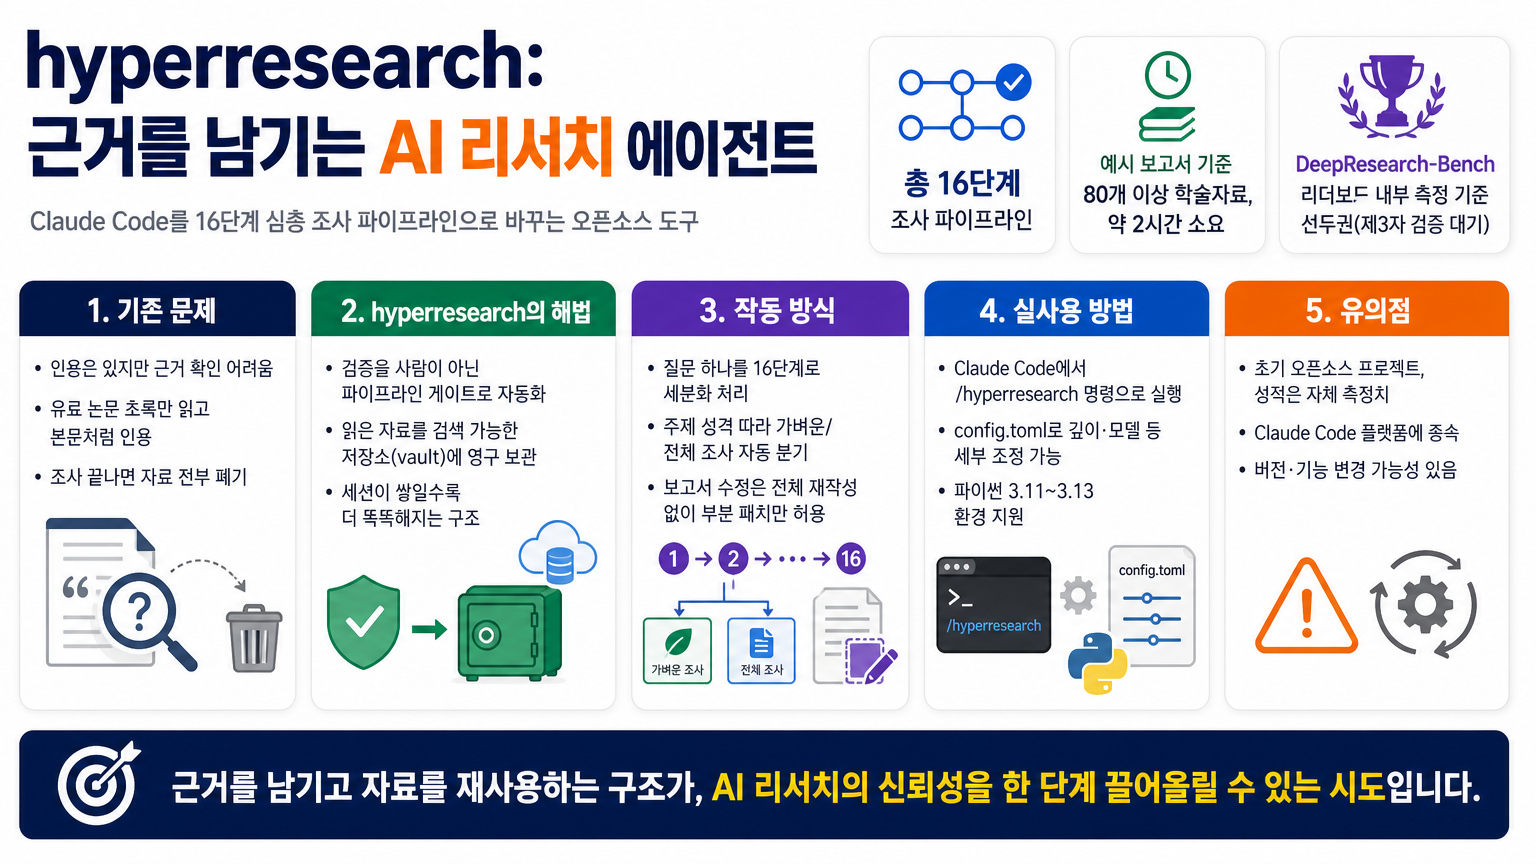
AI한테 어려운 주제를 조사해 달라고 시키면 보고서는 그럴싸하게 나오는데, 정작 그 AI가 자료를 제대로 읽고 쓴 건지 확인할 방법이 없다는 게 문제였습니다. 게다가 조사를 마치면 애써 모은 자료를 싹 다 버려서, 다음에 비슷한 주제를 또 조사하면 처음부터 다시 시작해야 했는데요. hyperresearch라는 도구는 이 문제를 해결하려고, 조사 과정을 16단계로 세분화하고 검증 절차를 아예 시스템 안에 심어 넣었으며, 한 번 읽은 자료는 검색 가능한 창고에 저장해 두었다가 다음 조사 때 재활용할 수 있게 만들었습니다. 쉽게 말하면 '숙제를 대충 베끼지 못하게 감시하는 선생님'과 '한번 산 책은 버리지 않고 서재에 꽂아두는 습관'을 AI 리서치에 붙인 셈입니다.
요약
hyperresearch는 Claude Code(앤스로픽의 코딩 에이전트 도구)를 심층 조사 전용 에이전트로 바꿔주는 오픈소스 파이프라인입니다. 사용자가 질문 하나를 던지면, 이 파이프라인이 총 16단계를 거쳐 근거 출처가 명확히 붙은 보고서를 만들어 냅니다. 기존 심층 조사 기능들이 겪던 문제, 즉 인용은 되어 있는데 그 문장을 진짜로 뒷받침하는지 알 수 없고, 유료 논문은 초록만 읽고도 본문을 다 읽은 것처럼 인용해버리는 문제를 구조적으로 막으려는 시도인데요. 검증을 '사람이 알아서 잘 하겠지'에 맡기지 않고, 파이프라인 안에 여러 개의 검증 관문(게이트)을 만들어 자동으로 걸러내는 방식이 핵심입니다.
특히 눈에 띄는 부분은 조사가 끝나도 읽은 자료가 사라지지 않고, 검색 가능한 개인 위키(저장소) 형태로 계속 쌓인다는 점입니다. 그래서 세션을 거듭할수록 다음 조사가 더 똑똑해지는 구조인데요. 개발사 측 설명으로는 DeepResearch-Bench라는 벤치마크의 RACE 리더보드에서 내부 테스트 기준 선두권 성적을 냈다고 밝히고 있지만, 이는 자체 측정 결과이며 외부 검증은 아직 진행 중이라는 점도 함께 밝혀두고 있습니다.
활용 포인트
실제로 써먹는 방법은 비교적 간단합니다. Claude Code 환경(파이썬 3.11~3.13 지원)에서 hyperresearch를 설치한 뒤 /hyperresearch <조사하고 싶은 주제>라고 입력하면, 주제의 성격에 따라 가벼운 조사(light)와 전체 조사(full) 중 하나가 자동으로 선택되어 진행됩니다. 예를 들어 개발자가 새로운 라이브러리를 도입하기 전에 관련 논문과 이슈를 폭넓게 훑어보고 싶을 때, 기획자가 시장 동향이나 경쟁 서비스 자료를 정리할 때, 학습자가 대학원 세미나 전에 특정 개념의 최신 연구 흐름을 파악할 때처럼 '자료를 많이 읽고 근거 있게 정리해야 하는' 상황에 적합합니다. 예시로 제공된 강화학습 탐험 전략 보고서는 80개 이상의 학술 자료(Semantic Scholar, arXiv, OpenAlex)를 읽고 약 2시간 만에 완성됐는데, 이런 식으로 사람이 하루 종일 걸릴 문헌 조사를 크게 단축해줄 수 있습니다.
또한 .hyperresearch/config.toml 설정 파일을 통해 조사 깊이(소스 개수, 분량 목표 등)나 각 단계에 쓰이는 AI 모델을 원하는 대로 바꿀 수 있어서, 가볍게 훑어볼 때와 논문 수준으로 파고들 때(dissertation 모드)를 상황에 맞게 조절할 수 있습니다. 보고서 작성 후 수정도 전체를 다시 쓰는 대신 필요한 부분만 콕 집어 고치는 '패치' 방식이라, 한 번 만든 보고서의 톤과 구조를 유지하면서 세부 내용만 다듬고 싶은 실무자에게 유용합니다.
주의 사항
hyperresearch는 아직 초기 단계의 오픈소스 프로젝트이고, 리더보드 선두 성적도 '내부적으로 측정한 파일럿 결과'라고 스스로 밝히고 있어 제3자 검증이 끝난 공인된 수치는 아닙니다. 또한 파이썬 3.14는 아직 지원하지 않는 등 버전 제약이 있고, Claude Code라는 특정 플랫폼에 종속된 도구라 다른 AI 도구 사용자에게는 바로 적용하기 어려울 수 있습니다. 오픈소스 프로젝트 특성상 명령어나 설정 방식, 지원 버전은 앞으로 계속 바뀔 수 있으니, 실제로 써보기 전에 GitHub 저장소의 최신 문서를 확인하는 게 안전합니다.
자체 검증
원문 자료들을 대조해보면, 16단계 파이프라인 구조, 읽은 자료를 영구 저장소(vault)에 보관해 재사용한다는 점, 인용 검증 단계(cite-checker)와 게이트가 별도로 존재한다는 점, 보고서 수정 시 전체 재작성이 아니라 부분 수정(패치)만 허용된다는 점은 모두 GitHub 저장소 설명에 명확히 나와 있어 사실로 확인됩니다. DeepResearch-Bench RACE 리더보드에서의 성적 역시 언급되어 있으나, 원문 스스로 '내부 벤치마크 기준', '제3자 검증 대기 중'이라고 명시하고 있어 이 글에서도 확정적 사실이 아닌 자체 측정치로 서술했습니다. 예시 보고서의 80개 이상 자료 수집, 약 2시간 소요, 58.3점이라는 구체적 수치도 저장소 내 예시 문서에 그대로 나와 있는 내용을 반영한 것입니다.
태그
#AI #딥리서치 #Claude #자동화 #리서치도구 #AI에이전트 #생산성
원문
https://discuss.pytorch.kr/t/hyperresearch-claude-code-16/11646
https://github.com/jordan-gibbs/hyperresearch