쉬운 설명
넷플릭스가 우리에게 영화나 드라마를 추천해 줄 때, 예전에는 사람이 일일이 규칙을 만들었습니다. '이 사람이 이런 영화를 봤으니 이런 특징을 체크해야 해'라며 수많은 계산식을 직접 짜서 사용했던 거죠. 하지만 이제는 챗GPT 같은 거대 언어 모델(LLM)에 넷플릭스 데이터를 새로 공부시켜서 추천을 맡기는 실험을 하고 있는데요. 이 새로운 시스템의 이름이 바로 'GenRec'입니다. 쉽게 말해 아주 똑똑한 비서에게 "이 사람이 최근에 뭘 봤고 지금 어떤 상황인지 알지? 다음에 뭘 보여주면 좋을지 순서를 정해줘" 하고 부탁하는 방식이라고 생각하시면 됩니다.
요약
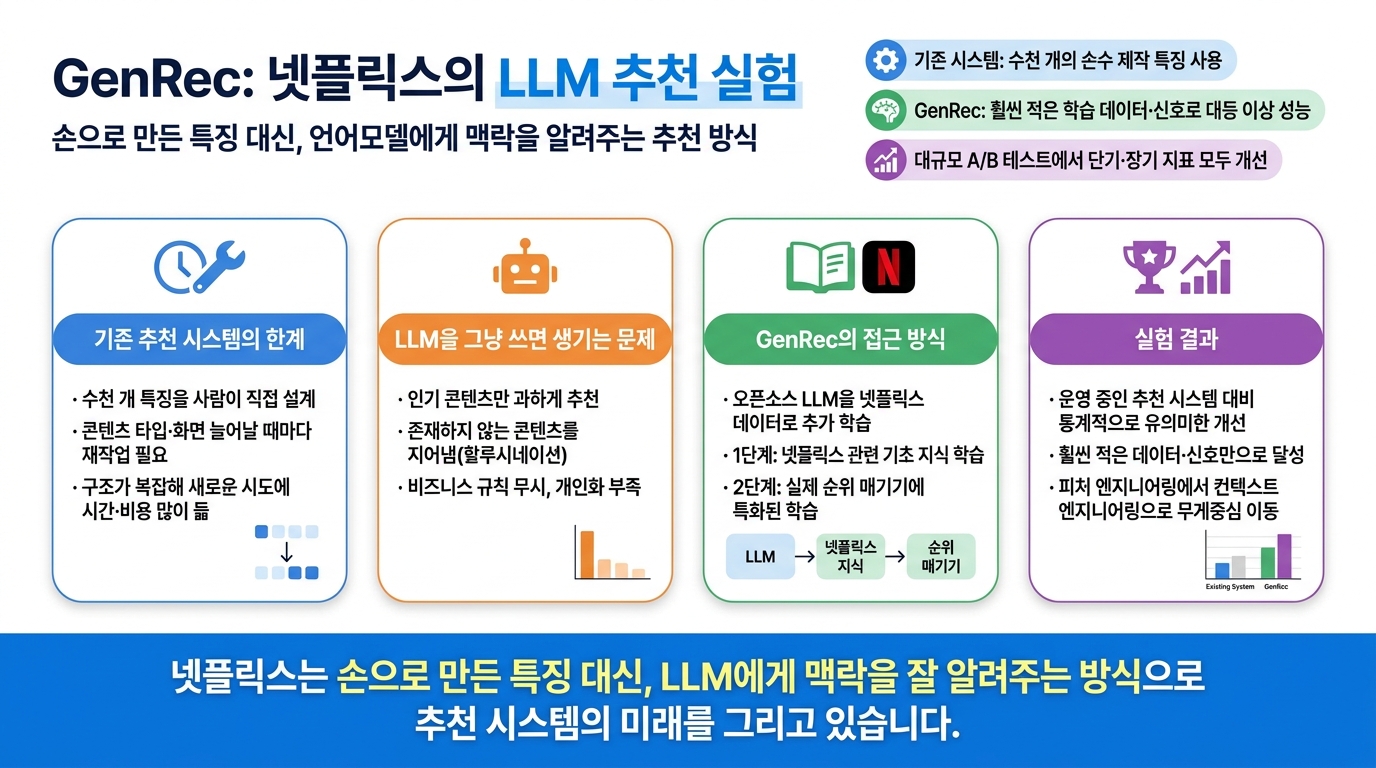
넷플릭스 기술 블로그에 소개된 이번 글은 자사의 차세대 추천 시스템인 'GenRec'을 다루고 있습니다. 기존 추천 시스템은 수천 개에 달하는 사람이 만든 특징(feature)과 시퀀스 모델링, 다중 목표 학습을 위한 전용 구조들이 복잡하게 얽혀 있었습니다. 그래서 영화, 시리즈, 게임, 라이브, 팟캐스트 같은 새로운 콘텐츠나 새로운 화면을 추가할 때마다 일일이 손을 봐야 해서 번거로웠죠. 반면 LLM은 세상 지식이 풍부하고 언어 이해력이 뛰어나서, 사용자의 시청 기록과 콘텐츠 정보를 그저 텍스트로 넣어주기만 해도 서로 어떤 관계가 있는지 잘 파악해 낸다는 장점이 있습니다. 다만 LLM을 아무런 가공 없이 그대로 가져다 쓰면 인기 콘텐츠만 너무 자주 추천하거나, 실제로 없는 콘텐츠를 지어내기도 하고, 비즈니스 규칙을 무시하는 문제가 생깁니다.
그래서 넷플릭스는 오픈소스 LLM을 가져와 자사 데이터로 두 단계에 걸쳐 추가 학습(post-training)을 진행했습니다. 1단계는 넷플릭스 관련 지식을 넓게 배우는 기초 학습이고, 2단계는 콘텐츠의 실제 순위를 정확히 매기는 능력에 집중한 학습입니다. 그 결과, 대규모 A/B 테스트에서 오랫동안 다듬어온 기존 운영 시스템보다 단기·장기 지표 모두에서 통계적으로 의미 있는 개선을 이루어냈다고 합니다. 정말 놀라운 점은 훨씬 적은 학습 데이터와 입력 신호만으로 이런 성과를 냈다는 사실인데요. 앞으로는 '어떤 특징을 사람 손으로 만들까'보다 '어떤 맥락(context)을 LLM에 잘 전달할까'가 훨씬 더 중요해질 수 있음을 보여줍니다.
강의용 팁
추천 시스템을 강의할 때 이 사례를 활용하면 '피처 엔지니어링에서 컨텍스트 엔지니어링으로의 전환'이라는 최신 트렌드를 설명하기 아주 좋습니다. 기존 방식(수천 개의 특징 + 전용 구조)과 LLM 기반 방식(텍스트 기반 기록·콘텐츠 표현 + 자연어 프롬프트 제어)을 표로 비교해 보여주면 수강생들이 그 차이를 한눈에 직관적으로 이해할 수 있습니다.
또한 LLM을 그냥 썼을 때 나타나는 한계점들, 즉 인기 콘텐츠 편향, 없는 내용을 지어내는 현상(할루시네이션), 비즈니스 규칙 무시 등을 함께 짚어주는 것도 좋습니다. 이를 바탕으로 "왜 챗GPT를 그대로 쓰지 않고 별도의 추가 학습을 해야 할까요?"라는 토론 주제를 던져보세요. 실습 시간: 간단한 영화 추천 프롬프트를 직접 작성해 보고, LLM이 실제 존재하지 않는 영화를 추천하는 모습을 직접 확인해 보는 미니 데모를 진행하면 교육 효과가 더 커집니다.
주의 사항
이 글은 넷플릭스 내부 시스템과 실험 결과를 소개하는 기술 블로그 내용이라, GenRec의 구체적인 모델 구조나 학습 데이터, 정확한 성능 수치 등 외부에 공개되지 않은 정보가 많습니다. 또한 넷플릭스라는 거대 기업의 방대한 데이터와 인프라를 전제로 한 사례이기 때문에, 일반적인 서비스나 소규모 프로젝트에 그대로 적용하기는 어려울 수 있습니다. 아울러 현재 실제 서비스에 완전히 적용된 기술이라기보다는 연구 및 실험 단계로 소개되고 있다는 점도 함께 언급해 주는 것이 좋습니다.
자체 검증
본문에서 다룬 핵심 내용들, 즉 기존 시스템이 수천 개의 손으로 만든 특징과 전용 구조를 쓴다는 점, LLM 기반 추천이 지닌 한계(인기 편향, 할루시네이션, 제한된 개인화), GenRec이 오픈소스 LLM을 기반으로 2단계 학습을 거친다는 점, 그리고 적은 데이터로도 대규모 A/B 테스트에서 통계적으로 의미 있는 개선을 보였다는 점은 모두 원문의 내용과 정확히 일치합니다. 원문 자체가 중간에 끊겨 있어 2단계 학습의 세부 절차나 정확한 성능 지표, 실험 규모 같은 구체적인 숫자는 원문에서도 확인할 수 없었는데요. 윤문 과정에서도 이를 멋대로 추측하지 않고 원문에서 공개된 수준으로만 작성했습니다.
태그
#AI #추천시스템 #LLM #넷플릭스 #머신러닝 #교육
원문
https://netflixtechblog.com/genrec-towards-llm-native-recommendation-at-netflix-f20be6f643e3
참고자료
Attention Is All You Need (Transformer 원논문)