쉬운 설명
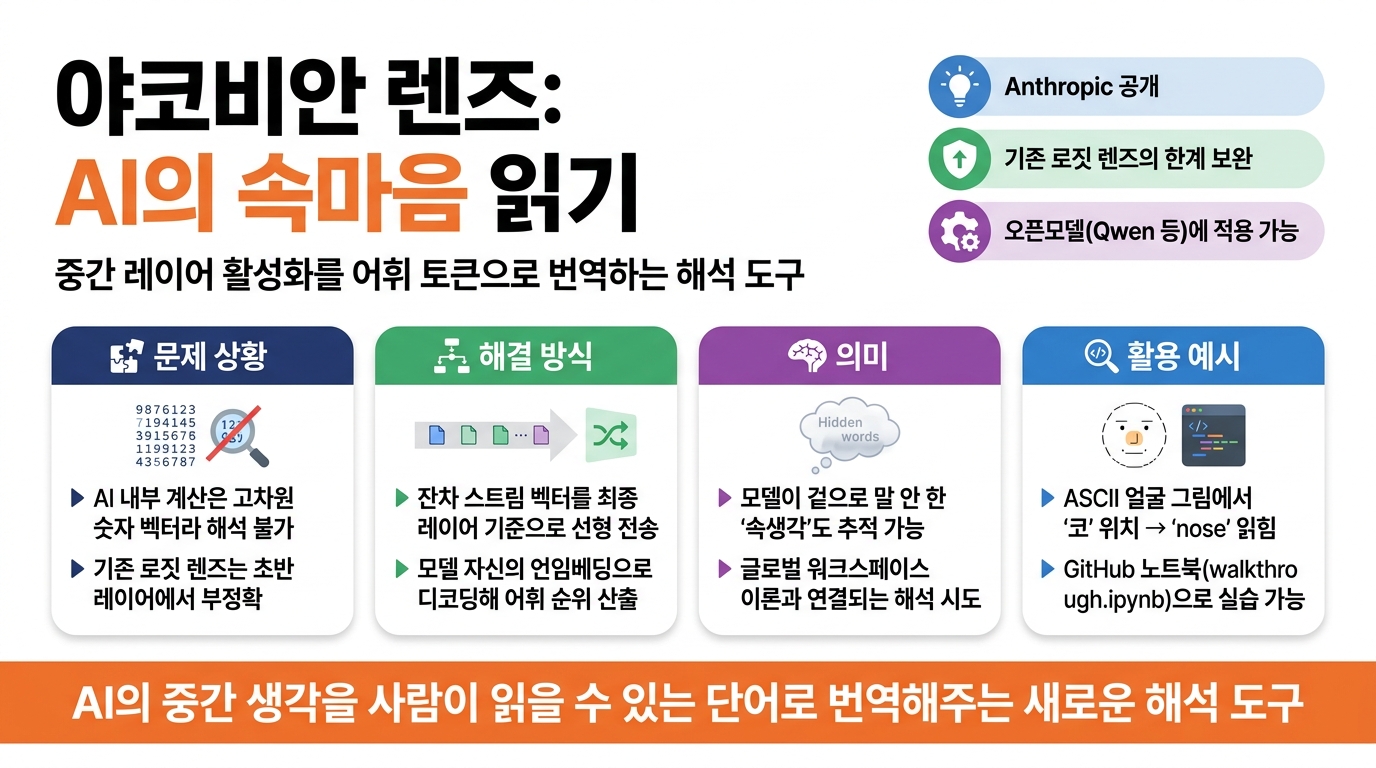
챗GPT 같은 언어 모델은 답을 내놓기 전에 내부에서 엄청나게 복잡한 계산을 거쳐요. 그런데 그 계산 중간 과정은 온통 숫자 덩어리라서, 사람이 그냥 보면 무슨 뜻인지 도무지 알 수가 없죠. '야코비안 렌즈(Jacobian Lens)'는 바로 이 숫자 덩어리를 'AI가 지금 떠올리는 단어'로 번역해 주는 도구예요. 마치 친구가 아직 입을 열지 않았어도 표정만 보고 '아, 얘 지금 무슨 말 하려고 하는구나!' 하고 속마음을 눈치채는 것과 비슷하답니다. Anthropic이라는 AI 기업이 이 도구를 공개했는데요, 덕분에 AI가 겉으로 말하지 않은 '속생각'까지 살짝 들여다볼 수 있게 되었습니다.
요약
이번에 소개해 드릴 내용은 Anthropic이 발표한 AI 내부 해석 도구, '야코비안 렌즈(J-lens)'예요. 기존에 많이 쓰이던 '로짓 렌즈(logit lens)'는 모델 중간 레이어의 활성화 값을 곧바로 최종 출력 단어로 바꾸어 보여주는 방식이었어요. 하지만 모든 레이어가 똑같은 좌표계를 쓴다고 무리하게 가정하는 바람에, 특히 초반 레이어에서는 해석 결과가 뒤죽박죽 엉키는 한계가 있었습니다. 야코비안 렌즈는 이 문제를 깔끔하게 해결해요. 중간 레이어의 잔차 스트림(residual stream, 모델 내부에서 정보가 쌓이며 흐르는 벡터) 벡터를 최종 레이어 기준에 맞춰 '선형 전송'한 뒤, 모델의 언임베딩으로 디코딩해 단어 순위를 정확히 뽑아냅니다.
더 흥미로운 점은 이 도구가 단순한 분석 기법을 넘어, Anthropic의 관련 논문에 나오는 '글로벌 워크스페이스(global workspace)' 개념과 이어진다는 거예요. 논문에서는 언어 모델 내부에 사람의 '의식적으로 접근할 수 있는 생각'과 유사한, 즉 보고·조작하고·추론하는 데 쓰이는 특별한 정보 집합이 존재한다는 증거를 제시하거든요. 모델이 겉으로 출력하지 않은 내부 추론이나 반응까지 이 렌즈로 들여다볼 수 있다는 뜻인데, AI가 왜 그런 답을 냈는지 밝혀내는 '해석가능성(interpretability)' 연구에서 매우 의미 있는 진전이라고 볼 수 있습니다.
강의용 팁
수업 시간에 '블랙박스 AI' 개념을 설명할 때 야코비안 렌즈를 예시로 들면 정말 좋아요. 로짓 렌즈와 비교하면서 '왜 중간 레이어를 그대로 읽으면 안 되는지' 알려주시면, 학생들이 신경망의 레이어 구조를 훨씬 직관적으로 이해할 수 있습니다. GitHub 저장소에 있는 walkthrough.ipynb 노트북을 활용해 보세요. Qwen 같은 오픈 모델에 직접 렌즈를 씌워보고, 특정 위치(포지션)에서 모델이 어떤 단어를 떠올리는지 시각화된 결과로 직접 보여줄 수 있거든요. 특히 ASCII 문자로 그린 얼굴 그림에서 코(^) 위치를 클릭하면, 프롬프트에 '코'라는 단어가 전혀 없어도 중간 레이어에서 'nose'를 떠올리고 있다는 걸 보여주는 데모는 학생들에게 강한 인상을 남길 겁니다.
아울러 "AI에게 과연 의식이 있을까?"라는 철학적 질문과 엮어 토론 수업으로 발전시켜도 좋습니다. 논문에서는 '접근 의식(access consciousness)'이라는 개념을 가져와 AI의 기능적 특성을 설명하고 있지만, 실제로 느끼는 주관적 경험(현상적 의식)과는 분명히 선을 긋고 있다는 점을 꼭 짚어주세요. 기술과 철학을 동시에 다루는 융합 수업 자료로 활용하기에 아주 뛰어납니다.
주의 사항
이 도구는 Anthropic이 공개한 '참고용 코드(reference implementation)'라서, 추후 지속적인 유지보수나 외부 기여를 받지 않는다고 명시되어 있어요. 코드 최적화가 되어 있지 않아 렌즈를 학습(fitting)시키는 데 시간이 제법 걸릴 수 있습니다. 또한 논문 출처가 2026년으로 표기된 극최신 연구인 만큼, 아직 학계에서 충분히 검증받지 않았을 가능성도 염두에 두어야 해요. 마지막으로 논문에서 '의식'이라는 단어를 쓰지만, 이는 오직 기능적인 측면에서의 정의일 뿐 AI가 사람처럼 주관적인 감정이나 경험을 갖는다는 뜻은 전혀 아니라는 점을 학생들에게 확실히 알려주시는 게 좋습니다.
자체 검증
원문 자료와 비교해 검증해 보니, 야코비안 렌즈가 잔차 스트림 벡터를 최종 레이어 기저로 '선형 전송'한 후 모델의 언임베딩으로 디코딩한다는 설명은 GitHub 저장소 내용과 정확히 맞습니다. 모든 레이어가 동일한 좌표계를 쓴다고 가정해 초반 레이어 해석이 어렵다는 로짓 렌즈의 한계도 원문 내용 그대로예요. ASCII 얼굴 예시에서 코(^) 위치를 클릭했을 때 프롬프트에 없는 단어인 'nose'가 중간 레이어에서 읽힌다는 부분 역시 명시된 사실입니다. 다만 '글로벌 워크스페이스' 논문의 세부 실험 수치(예: §9.3의 '품질이 프롬프트 100개 정도에서 포화된다'는 내용 등)는 요약 자료만으로는 전체 맥락을 온전히 파악하기 어려우므로, 더 깊이 있게 다루고자 하신다면 논문 원문을 직접 확인해 보시는 것을 추천해 드립니다.
태그
#AI #해석가능성 #언어모델 #Anthropic #AI교육 #딥러닝 #인공지능윤리
원문
https://discuss.pytorch.kr/t/jacobian-lens/11341
https://transformer-circuits.pub/2026/workspace/index.html
https://github.com/anthropics/jacobian-lens
참고자료
Anthropic Transformer Circuits - 해석가능성 연구 모음