쉬운 설명
로봇을 처음 움직여 본다고 한번 상상해 보세요. 자전거 타는 법을 책으로 아무리 열심히 배웠어도, 실제로 페달을 밟는 순간 몸이 마음대로 움직이지 않는 것과 비슷합니다. 글을 이해하고 문장을 만들어내는 AI인 '언어 모델'도 마찬가지인데요. 책이나 인터넷을 통해 물리 법칙이나 로봇 공학 지식은 아주 많이 공부했지만, 막상 그 지식으로 실제 로봇의 관절을 움직여 물건을 옮기거나 걷게 만드는 건 완전히 다른 차원의 문제입니다.
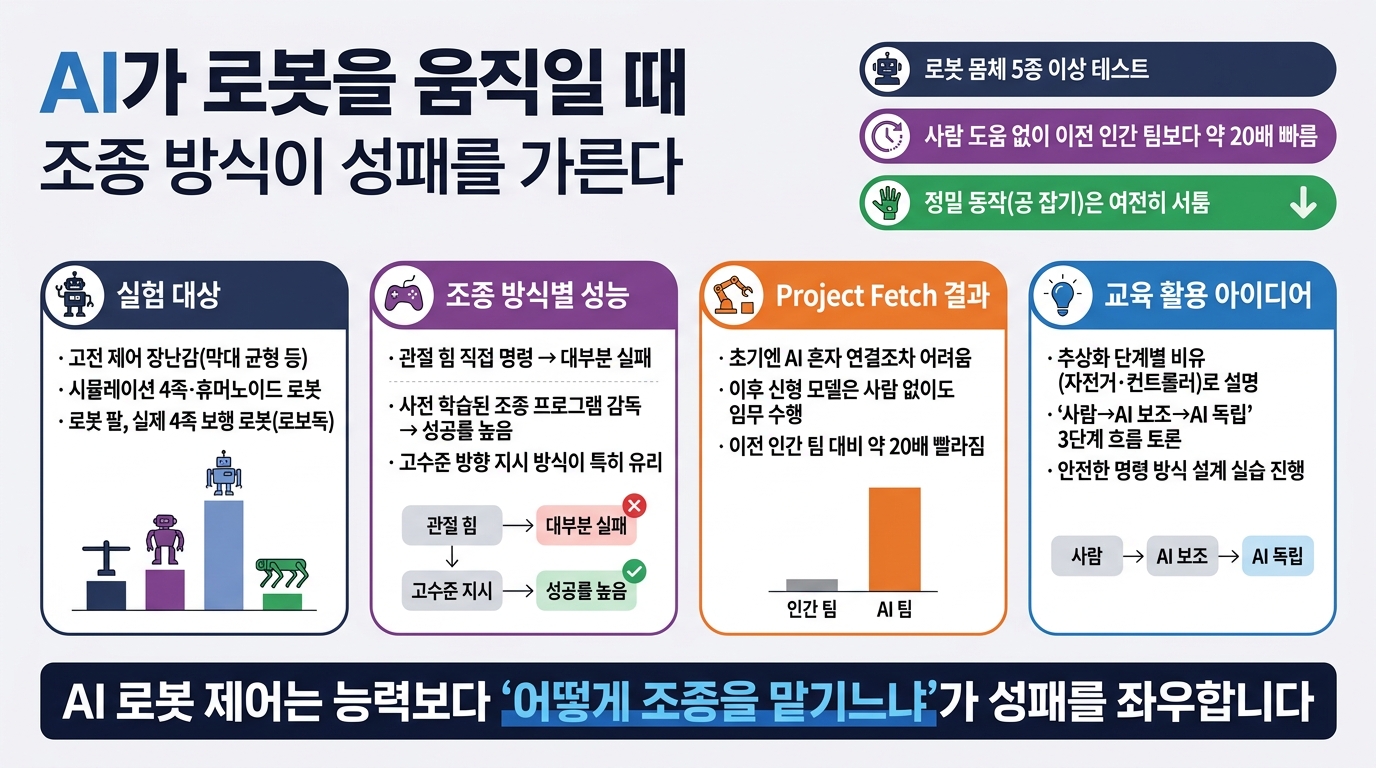
유명 AI 기업인 앤스로픽(Anthropic)이 이 부분을 직접 실험해 보았는데요. 아주 흥미로운 결과가 나왔습니다. AI가 로봇을 얼마나 잘 다루는지는 바로 'AI에게 얼마나 세세한 명령을 내리느냐'에 따라 크게 달라진다는 점입니다. 예를 들어 "관절 하나하나에 힘을 얼마큼 줘서 움직여라"처럼 너무 세세한 동작을 직접 시키면 AI가 잘하지 못했습니다. 반면, "저쪽으로 걸어가라"처럼 이미 잘 만들어진 조종 프로그램에 방향만 지시하는 방식으로 역할을 맡기자, 실제로 로봇이 걷고 물건을 척척 집어 올릴 수 있었다고 합니다.
요약
앤스로픽은 최근 두 가지 흥미로운 실험 결과를 발표했습니다. 첫 번째는 다양한 AI 모델에게 여러 형태의 로봇(기본적인 제어용 장난감, 가상 공간의 4족 로봇과 휴머노이드, 로봇 팔, 그리고 실제 4족 보행 로봇인 'Unitree Go2')을 맡겨 성능을 테스트한 '벤치마크 연구'입니다. 여기서 발견한 가장 중요한 사실은, AI 자체의 똑똑함보다 '로봇을 어떤 방식으로 조종하느냐'가 성공과 실패를 가른다는 점이었습니다. AI가 로봇 관절의 힘을 직접 하나하나 계산해서 움직이게 하는 방식은 대부분 실패했습니다. 하지만 이미 만들어진 조종 프로그램(정책)을 AI가 감독하게 하거나, 단순히 방향만 지시하도록 도구를 쥐여주었을 때는 이동이나 물건을 다루는 임무를 훌륭히 완수해 냈습니다.
두 번째는 실제 사무실에서 직원들과 로봇이 함께 임무를 수행한 '프로젝트 페치(Project Fetch)'라는 현장 실험입니다. 2025년 8월, 로봇 전문가가 아닌 일반 직원들이 AI인 클로드(Claude)의 도움을 받아 로봇 강아지를 다루는 실험을 진행했는데요. 클로드 없이 인터넷 검색에만 의존했던 팀보다 클로드의 도움을 받은 팀이 훨씬 더 빠르게 임무를 완수했습니다. 그리고 몇 달 뒤, 더 똑똑해진 최신 모델(Claude Opus 4.7)로 다시 실험을 해보았는데요. 놀랍게도 이번에는 사람의 도움 없이 AI가 혼자 일했는데도, 지난번 사람 팀보다 약 20배나 빠르게 임무를 끝마쳤다고 합니다. 물론 공을 정확하게 물어오는 핵심 동작(페칭)은 여전히 조금 서툴렀다는 한계도 솔직하게 인정했는데요. 비록 완벽하진 않지만, AI가 실제 로봇을 제어하는 능력이 얼마나 빠르게 발전하고 있는지 보여주는 중요한 사례입니다.
강의용 팁
이 내용을 수업에서 소개하실 때는 '로봇 조종 방법의 추상화 수준'이라는 개념을 함께 다뤄주시면 정말 좋습니다. 관절의 힘을 직접 계산하는 아주 세세한 방식(저수준)부터, 코드를 작성하는 방식, 강화학습으로 새로운 조종기를 학습시키는 방식, 그리고 이미 완성된 조종 프로그램에 방향만 가리키는 방식(고수준)까지 단계별로 설명해 주는 것인데요. 이렇게 비교해 주면 학생들이 "왜 AI가 어떤 일은 잘하고, 어떤 일은 쩔쩔매는지"를 아주 쉽게 이해할 수 있습니다. 자전거나 게임기 조이스틱을 예로 들어 "누가 직접 페달을 밟고, 누가 방향을 정해주는지" 비유해서 설명하면 훨씬 효과적입니다.
더불어 '프로젝트 페치' 사례는 'AI가 사람을 돕다가, 사람이 AI를 돕게 되고, 결국에는 AI가 스스로 해내는' 3단계 자동화 흐름을 보여주기에 아주 훌륭한 교재입니다. 실제로 사이버 보안 분야에서도 이와 비슷한 흐름이 나타났었는데요. 다른 분야의 성공 사례들과 엮어서 "우리 삶에서 AI 자동화는 어떤 단계를 거쳐 발전하게 될까?"라는 토론 주제로 연결해 보시는 것을 추천합니다. 실습 시간에는 학생들이 직접 "내가 만약 로봇을 조종한다면 어떤 방식으로 명령을 내리는 것이 가장 효율적이고 안전할까?"를 고민하며 설계해 보는 활동을 해보는 것도 아주 좋습니다.
주의 사항
몇 가지 주의해야 할 점도 있습니다. 이 실험은 앤스로픽(Anthropic)이 자사 AI 모델인 클로드(Claude) 시리즈로 진행한 결과이므로, 다른 회사의 AI 모델에도 무조건 똑같이 적용된다고 보기는 어렵습니다. 또한 프로젝트 페치의 '20배나 빠르다'는 결과 역시 아주 제한적인 환경(딱 3회만 실행했고, 연구자가 명령을 승인해 주는 조건)에서 특정 임무를 수행했을 때 얻은 수치입니다. 공을 정확하게 가져오는 것과 같은 정밀한 움직임 제어에는 여전히 한계가 있다는 점을 원문에서도 명시하고 있습니다. 마지막으로, 실험에 쓰인 AI 버전(Opus 4.1, 4.7 등)은 앞으로 더 업그레이드될 테니, 강의 자료로 활용하실 때는 실험이 진행된 시점(2025년 8월 이후)과 사용된 버전 정보를 명확히 짚어주시는 것이 좋습니다.
자체 검증
원문 내용을 꼼꼼히 확인해 본 결과, "로봇 조종 방식(추상화 수준)에 따라 성능 차이가 크게 난다"는 핵심 주장은 앤스로픽의 공식 리서치 보고서에 명확히 기록되어 있습니다. 로봇 관절의 힘을 직접 조절하라는 세세한 명령은 대부분 실패했고, 이미 학습된 움직임 기능을 높은 수준에서 지시하고 감독할 때 성공률이 높아졌다는 설명 역시 원문과 똑같이 일치합니다.
또한, 프로젝트 페치 실험에서 "사람의 도움 없이 최신 모델(Opus 4.7)이 이전 사람 팀보다 약 20배나 빠른 속도로 과제를 수행했다"는 내용과, 그럼에도 "공을 집어 오는 등의 정밀한 물리 제어는 여전히 서툴렀다"는 한계점 모두 과장 없이 원문 그대로를 반영했습니다. 다만, 실험에 쓰인 로봇이 'Unitree Go2'라는 4족 보행 로봇(로보독)이라는 점과, 이번 실험의 양상이 사이버 보안 분야의 발전 과정과 비슷하다는 설명은 원문의 비유적 표현을 충실히 따른 것입니다. 이 흐름이 모든 산업 분야에 똑같이 일반화되어 적용된다고 원문에서 단정한 것은 아니라는 점을 참고해 주시기 바랍니다.
태그
#AI #로보틱스 #Claude #Anthropic #AI교육 #LLM #실습교육
원문
https://discuss.pytorch.kr/t/llm-anthropic-embody/11261
https://www.anthropic.com/research/claude-plays-robotics
https://www.anthropic.com/research/project-fetch-phase-two
참고자료
Claude Plays Robotics (Anthropic Research)
Project Fetch: Phase Two (Anthropic Research)